RNA-seqや空間トランスクリプトミクスなどのオミクス解析において、群間で発現量が変化している遺伝子(DEG: Differentially Expressed Genes)を探す際に必ず登場する2大パッケージが「limma-voom」と「edgeR」です。
しかし、実際に両方の手法で同じデータを解析してみると、「limma-voomでは40個の遺伝子が検出されたのに、edgeR(準尤度F検定)では10個に絞られた」といった結果の違いに戸惑うことが少なくありません。
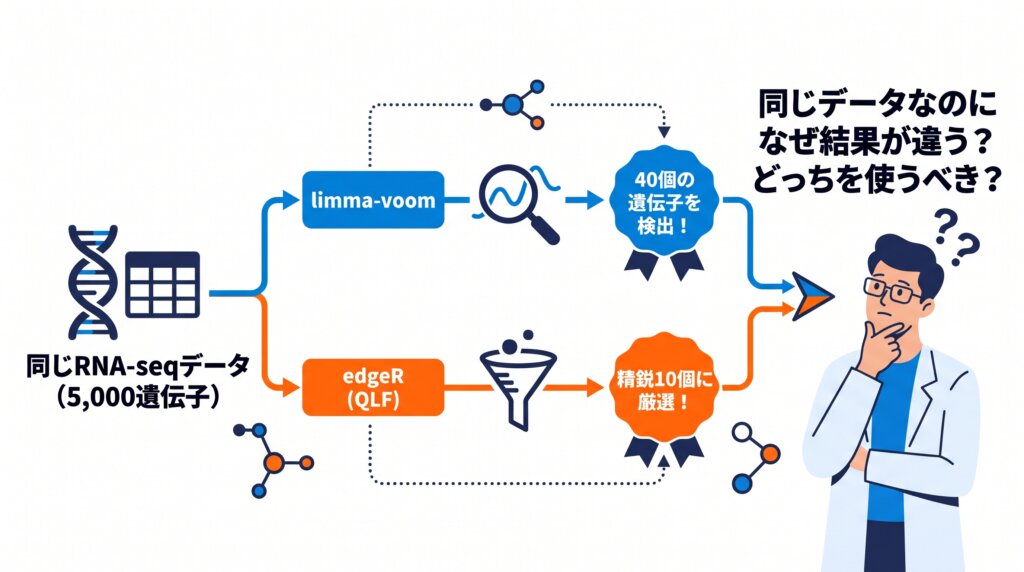
「結局、limma-voomとedgeRはどっちを使えばいいの?」「中身の計算はどう違うの?」という疑問をスッキリ解決しましょう!
本記事では、前半で「中学生でも直感的に仕組みがわかる図解編」をお届けし、後半で「技術者・研究者向けの統計モデル詳解&R実践コード編」を段階的に解説します。
【結論】limma-voomとedgeRの違いと選び方早見表
まずは結論として、2つの手法のアルゴリズムの違いと実務での使い分け基準を一覧表にまとめます。
| 比較項目 | limma-voom | edgeR(QLF:準尤度F検定) |
|---|---|---|
| データの扱い | カウントを対数変換(連続値)して扱う | 生のカウントデータ(整数)のまま扱う |
| Step 1:正規化 | CPM(総リード数補正)+ TMM | TMM正規化(上下30%トリミング) |
| Step 2:統計モデル | 正規分布ベースの線形モデル + 逆分散重み付け(voom) | 負の二項分布(NB)による一般化線形モデル(GLM) |
| Step 3:検定手法 | moderated t検定(経験ベイズ法による分散の収縮) | 準尤度F検定(QLF)(分散予測の不確実性を考慮) |
| 偽陽性(ノイズ)への強さ | 中〜高(サンプル数が多いと非常に安定) | 非常に高い(少数サンプルでも偽陽性を厳格に排除) |
| 計算スピード | 超高速(数万遺伝子・大規模データでも一瞬) | やや重い(GLMの反復計算を行うため) |
| おすすめの場面 | ・サンプル数が多い研究(各群 n ≥ 10 など) ・複雑な実験デザイン・混合効果モデル ・大規模データの高速スクリーニング | ・少数サンプル研究(各群 n = 3〜5 など) ・低発現遺伝子が多いデータ ・偽陽性を徹底的に減らして精鋭遺伝子を絞りたい時 |
迷ったときの選び方ルール
・サンプル数が少ない(3 vs 3 や 5 vs 5)& 偽陽性を厳しく抑えたい ➔ edgeR(glmQLFTest)
・サンプル数が多い & 計算速度や線形モデルの柔軟性を重視したい ➔ limma-voom
【簡単な説明】そもそも「遺伝子の量を比べる」ってどういうこと?
ここからは、数学の難しい式を使わずに「なぜ2つの手法で結果が変わるのか?」を3つのステップ(①正規化、②モデル化、③検定)でイメージしてみましょう。
たとえば、「健康な人5人(Aグループ)」と「病気の患者さん5人(Bグループ)」の細胞から、約5,000種類の遺伝子の数(カウント数)を数えて、病気の原因になっている遺伝子を探すとします。
Step 1:正規化 〜「全体の人数」が違うテストをどう比べる?〜
遺伝子を数える機械(シーケンサー)は、サンプルごとに読み取れる「合計の数」がバラバラです。患者Aからは合計100万個、患者Bからは合計200万個の遺伝子が読み取れた場合、そのままの個数では比べられませんよね。
① シンプルな「割合」で比べる方法(CPM)と『大食い1人の罠』
一番簡単なのは、「全体の合計数で割って、100万個あたりの割合(CPM)にする」という方法です(中学校で習う「割合・パーセント」と同じです)。
しかし、ここには「分母膨張の罠」があります。もし患者Bの体の中で、今回の病気とは無関係な「暴れん坊の遺伝子X」だけが1人で大量に増えていたらどうなるでしょうか?
全体の合計(分母)が大きく膨らんでしまうため、本当は患者Aと患者Bでまったく同じ100個ずつ存在する「普通の遺伝子A」まで、割り算の結果、患者Bで半分に減ってしまったように錯覚してしまうのです。
② 極端な外れ値をカットする「TMM正規化」
この罠を防ぐのが、edgeRなどで使われる「TMM正規化」です。
TMM正規化は、「極端に増えすぎている上位30%」と「極端に減りすぎている下位30%」の遺伝子を最初から計算から除外(カット)します。残った「真ん中の落ち着いた遺伝子たち」だけで基準を合わせるため、暴れん坊の遺伝子に騙されずに本当の基準線を見つけることができます。
Step 2:モデル化 〜データの「ブレ(ばらつき)」をどう扱う?〜
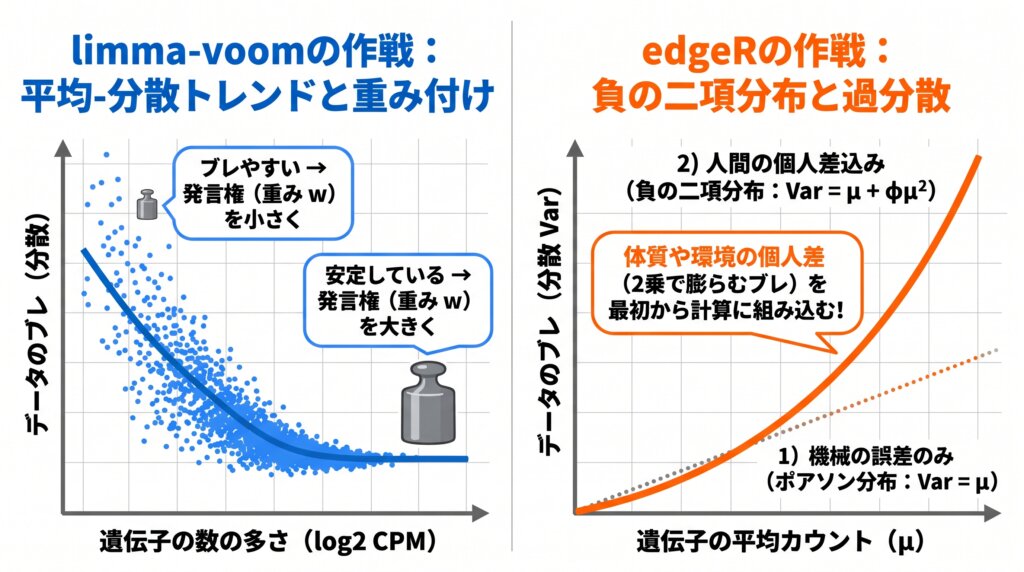
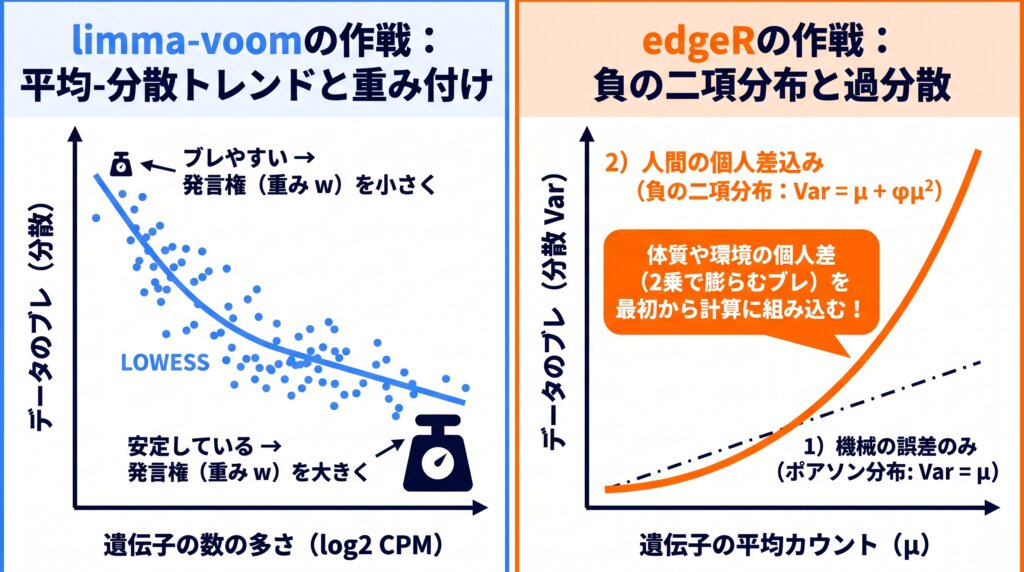
基準を揃えたら、次はグループ間の差を計算します。ここで問題になるのが「人間には個人差(データのブレ)がある」ということです。このブレへの向き合い方が、limma-voomとedgeRで大きく異なります。
① limma-voomの作戦:「声が小さいデータはブレやすいから、発言権を小さくしよう」
limma-voomは、個数のデータを「対数(log2)」という滑らかな小数のデータに変換します。
すると、「もともと数が少ない(声が小さい)遺伝子ほど、ちょっとしたことで数字が大きくブレる」という性質が見えてきます。
そこでvoomは、「ブレやすい(数が少ない)遺伝子には小さい重み(発言権ダウン)を、安定している(数が多い)遺伝子には大きい重み(発言権アップ)をつける」というルールを作って、フェアに計算できるようにします。
② edgeRの作戦:「人間の個人差は『2乗』で膨らむものとして計算しよう」
一方、edgeRはデータを小数に変換せず、生の「個数(整数)」のまま扱います。
サイコロを振るような単なる機械の誤差なら、ブレの大きさは平均値に比例します(直線)。しかし、生きている人間のデータには体質や環境などの「個人差」があるため、遺伝子の数が増えるほど、ブレが「2乗(二次関数のカーブ)」で急激に大きくなる性質(過分散)があります。
edgeRは、この二次関数のカーブを直接計算式に組み込むことで、「人間同士を比べているんだから、このくらい大きくブレるのは当たり前だよね」と冷静に判定します。
Step 3:検定 〜「たまたまの一致」を防ぐ〜
最後は、「本当に病気のせいで差が出たのか?(合格・不合格)」を判定するテスト(統計検定)です。5人 vs 5人のような少ない人数で比べると、「たまたま5人の数字がピタッと揃ってしまい、ブレがゼロに見える遺伝子」が偶然現れます。すると計算式の分母がゼロに近くなり、ちょっとした差なのに「ものすごい大発見だ!」と誤判定(偽陽性)してしまいます。
① limma-voomの「moderated t検定」:みんなの平均へ引き寄せる
この暴走を防ぐため、limma-voomは「5,000個の遺伝子全体の平均的なブレ」を計算し、極端にブレが小さすぎる(または大きすぎる)遺伝子を、全体の平均に向かってギュッと引き寄せる(収縮させる)という工夫をします。これにより、たまたま5人の数字が揃っただけの遺伝子が暴走するのを防ぎます。
② edgeRの「準尤度F検定(QLF)」:合格ライン自体をさらに厳しくする
edgeRの最新標準である「準尤度F検定(QLF)」は、さらに厳格です。
「Step 2で引いた二次関数のカーブ自体にも、まだ予測しきれないブレ(誤差の誤差)があるよね」と考え、合格ライン(閾値)そのものを厳しい右側へ引き上げます。
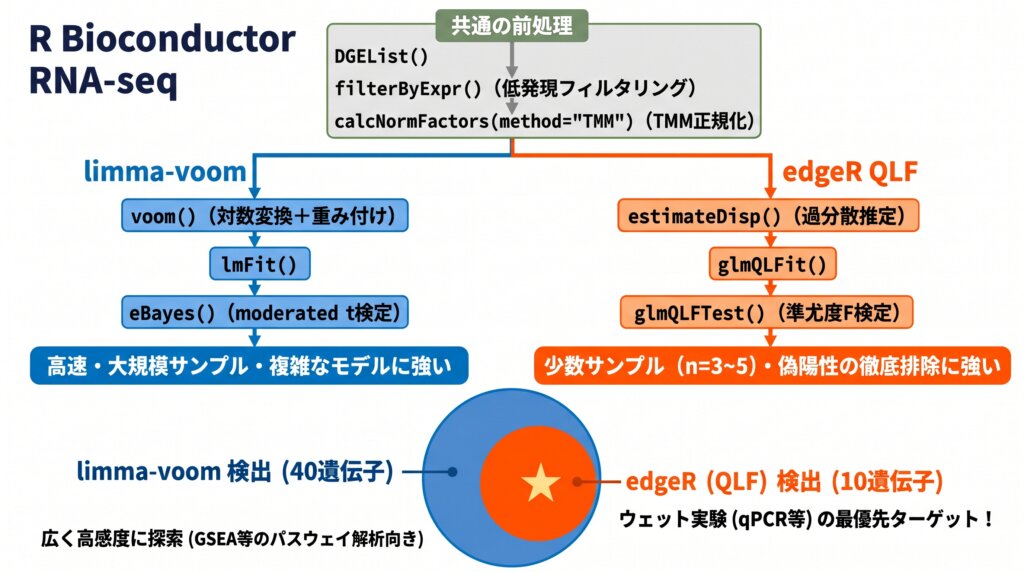
その結果、limma-voomの基準ではギリギリ合格していたグレーゾーンの遺伝子(たとえば40個中30個)が「まだ証拠不十分!」としてふるい落とされ、本当に間違いのない精鋭の10遺伝子だけが生き残るのです。
つまり、どちらかが間違っているわけではなく、「滑らかな連続値に変換してバランスよく拾うlimma-voom」と、「カウントのまま二重の安全装置をかけて本物だけを厳選するedgeR(QLF)」という設計思想の違いなのです。
【技術者・研究者向け】limma-voomとedgeRの統計モデルとアルゴリズム詳解
ここからはバイオインフォマティシャン・データサイエンティスト向けに、両手法の背後にある数理統計モデルとアルゴリズムの詳細を掘り下げます。
1. 正規化の数理:CPMとTMM(Trimmed Mean of M-values)
サンプル i における遺伝子 g のリードカウントを ygi、サンプル i の総リード数(ライブラリサイズ)を Ni = Σg ygi とします。
CPMとlog2-CPM変換
単純な総量補正であるCPM(Counts Per Million)および、voomで用いられる対数変換値 rgi は以下の式で定義されます(ゼロ除算と対数発散を防ぐため、微小なオフセット値 0.5 を加算します)。
rgi = log2( (ygi + 0.5) / (Ni + 1.0) × 106 )
TMM正規化(Robinson & Oshlack, 2010)
一部の高発現遺伝子による組成バイアス(RNA composition bias)を補正するため、基準サンプル r と対象サンプル k の間で、遺伝子ごとの対数発現比(Mg 値)と平均対数発現量(Ag 値)を算出します。
- 対数変化比(M値):Mg = log2( (ygk / Nk) / (ygr / Nr) )
- 平均発現量(A値):Ag = 0.5 × log2( (ygk / Nk) × (ygr / Nr) )
TMMでは、Mg の上下30%および Ag の上下5%をトリミング(除外)した残りの遺伝子集合に対して、漸近分散の逆数を重みとした加重平均を計算し、正規化係数(Normalization factor)を導出します。これを元のライブラリサイズ Ni に乗じた「有効ライブラリサイズ(Effective Library Size)」を分母として用います。
2. limma-voomの数理:Mean-Varianceトレンドと経験ベイズ
元来マイクロアレイ(正規分布に従う連続値)向けに開発された limma パッケージを、RNA-seqのカウントデータに適用可能にしたのが voom(Variance modeling at the observational level; Law et al., 2014) です。
- 線形モデルの仮当て:各遺伝子の log2(CPM) 値 rgi に対してデザイン行列 X で通常の最小二乗法(OLS)を当てはめ、残差標準偏差 sg を算出します。
- LOWESSトレンド曲線の推定:各遺伝子の平均対数カウントに対して √sg をプロットし、非パラメトリックな局所回帰曲線(LOWESSトレンド)をフィットさせます。
- 観測レベル重み(Precision weights)の算出:各観測値の予測対数カウントをトレンド曲線に代入し、予測分散の逆数(wgi = 1 / 予測分散)を重みとして各データ点(遺伝子×サンプル)に付与します。
- Empirical Bayes moderated t-test:重み付き最小二乗法(WLS)で推定した各遺伝子の残差分散 sg2 を、全遺伝子の共通事前分散 s02 へ収縮させた事後分散 s̃g2 を算出します。
調整後の事後分散: s̃g2 = (d0s02 + dgsg2) / (d0 + dg)
ここで dg はサンプルの残差自由度、d0 は経験ベイズ法で推定された事前自由度です。自由度が dg + d0 に増加した moderated t統計量 を用いることで、少数サンプルでも分母の偶然の縮小による偽陽性を防ぎます。
3. edgeRの数理:負の二項分布GLMと準尤度F検定(QLF)
edgeR(Robinson et al., 2010; Lun et al., 2016)は、カウントデータ ygi が平均 μgi、生物学的過分散パラメータ(Dispersion)φg を持つ負の二項分布(Negative Binomial distribution: NB)に従うと仮定します。
負の二項分布の分散: Var(ygi) = μgi + φgμgi2
第1項 μgi はシーケンシングのサンプリング誤差(ポアソン分散/ショットノイズ)、第2項 φgμgi2 は個体間の生物学的変動(Biological Coefficient of Variation: BCV = √φg)を表します。
なぜ「尤度比検定(LRT)」ではなく「準尤度F検定(QLF)」なのか?
従来の glmFit + glmLRT(尤度比検定)では、推定された分散パラメータ φg を「真の既知の値」として扱いカイ二乗分布で検定するため、少数サンプルでは分散推定の不確実性が無視され、FDR(偽発見率)が名目水準を超えて膨らむ傾向がありました。
現在のベストプラクティスである 準尤度F検定(glmQLFit + glmQLFTest) では、負の二項分布の分散構造の上にさらに遺伝子固有の準尤度分散倍率 σg2 を導入します。
準尤度モデルの分散: Var(ygi) = σg2 ( μgi + φgμgi2 )
この σg2 を limma と同様の経験ベイズ法で収縮させ、カイ二乗分布ではなく裾の重いF分布を用いて検定を行うため、第一種の過誤(偽陽性)が極めて厳格にコントロールされます。
【実践コード】Rによるlimma-voomとedgeRの比較解析パイプライン
ここからは、実際にR(Bioconductor)を用いて、同じカウント行列から limma-voom と edgeR (QLF) の両方を実行し、結果を比較する標準コードを掲載します。
前処理のポイント:低発現フィルタリング(filterByExpr)とTMM正規化(calcNormFactors)までは、両手法ともまったく同じオブジェクト(DGEList)を共通で使います。
1. 共通の前処理(パッケージ読み込み・フィルタリング・TMM正規化)
library(edgeR)
library(limma)

# 1. カウント行列 (counts: 行=遺伝子, 列=サンプル) と群情報 (group) の準備
# 例: Control 5サンプル vs Treated 5サンプル
group <- factor(c(rep("Control", 5), rep("Treated", 5)))
design <- model.matrix(~ 0 + group)
colnames(design) <- levels(group)

# 2. DGEListオブジェクトの作成
y <- DGEList(counts = counts, group = group)

# 3. 低発現遺伝子の自動フィルタリング (統計的検出力のないノイズ遺伝子を除外)
keep <- filterByExpr(y, design = design)
y <- y[keep, , keep.lib.sizes = FALSE]

# 4. TMM正規化係数の算出
y <- calcNormFactors(y, method = "TMM")
2. 第1ルート:limma-voom による解析コード
# 1. voom変換(Mean-Varianceトレンド推定と重み付け)
v <- voom(y, design, plot = TRUE)

# 2. 線形モデルの当てはめとコントラスト設定
fit <- lmFit(v, design)
contrast.matrix <- makeContrasts(Treated_vs_Control = Treated - Control, levels = design)
fit2 <- contrasts.fit(fit, contrast.matrix)

# 3. 経験ベイズ法による分散収縮とmoderated t検定
fit2 <- eBayes(fit2)

# 4. 結果の抽出(FDR < 0.05)
res_voom <- topTable(fit2, coef = "Treated_vs_Control", number = Inf, sort.by = "P")
deg_voom <- subset(res_voom, adj.P.Val < 0.05)
cat("limma-voom 検出遺伝子数:", nrow(deg_voom), "\n")
3. 第2ルート:edgeR(準尤度F検定:QLF)による解析コード
# 1. 負の二項分布の過分散パラメータ (Common / Trended / Tagwise Dispersion) の推定
y <- estimateDisp(y, design, robust = TRUE)
plotBCV(y)

# 2. 準尤度負の二項一般化線形モデル (QL-GLM) の当てはめ
# robust = TRUE により極端な外れ値遺伝子の影響を抑制
fit_ql <- glmQLFit(y, design, robust = TRUE)

# 3. 準尤度F検定 (QLF test) の実行
qlf <- glmQLFTest(fit_ql, contrast = contrast.matrix[, "Treated_vs_Control"])

# 4. 結果の抽出(FDR < 0.05)
res_edger <- topTags(qlf, n = Inf)$table
deg_edger <- subset(res_edger, FDR < 0.05)
cat("edgeR (QLF) 検出遺伝子数:", nrow(deg_edger), "\n")
実務での使い分けガイドライン: どちらを使用すれば良いか?
実際の研究プロジェクトでどちらを採用すべきか迷った際は、以下の3つの基準で判断するのがおすすめです。
- サンプルサイズが小さい場合(各群 n = 3〜5)は「edgeR (QLF)」
サンプル数が少ない場合、voomの対数変換+正規近似よりも、離散カウントを直接モデル化する負の二項分布+準尤度F検定(glmQLFTest)の方が第一種の過誤(偽陽性)を正確に抑制できます。 - サンプルサイズが大きい場合や複雑な共変量モデルには「limma-voom」
各群10サンプル以上あるコホート研究や、同一患者からの反復測定(duplicateCorrelationによる変量効果の導入)などを行う場合は、線形モデルの拡張性と計算速度に優れたlimma-voom(またはサンプルごとの品質重みも同時推定するvoomWithQualityWeights)が圧倒的に便利です。 - ウェット実験(qPCRや免疫染色)でバリデーションを行うなら両方確認する
探索的なパスウェイ解析(GSEAやGO解析)には感度の高いリストを用い、ウェット実験で検証するトップ候補遺伝子の絞り込みにはedgeR (QLF)とlimma-voomの共通部分(Intersection)を採択すると、再現性の高い堅牢なターゲット選定が可能です。
まとめ
本記事では、バイオインフォマティクスの発現変動解析における2大手法「limma-voom」と「edgeR」の違いについて解説しました。
- 正規化:単純な割合(CPM)の「分母膨張の罠」を防ぐため、上下30%をトリミングするTMM正規化が重要。
- limma-voom:カウントを log2(CPM) の連続値に変換し、平均-分散トレンドから逆分散重みを付与してmoderated t検定で高速・柔軟に解く。
- edgeR (QLF):カウントのまま負の二項分布(二次関数の過分散モデル)を当てはめ、準尤度F検定で分散予測の不確実性まで考慮して偽陽性を厳格に排除する。
データのサンプルサイズや研究の目的(広く探索したいのか、偽陽性を排除して精鋭を絞りたいのか)に合わせて、ぜひ最適な手法を選択してみてください。